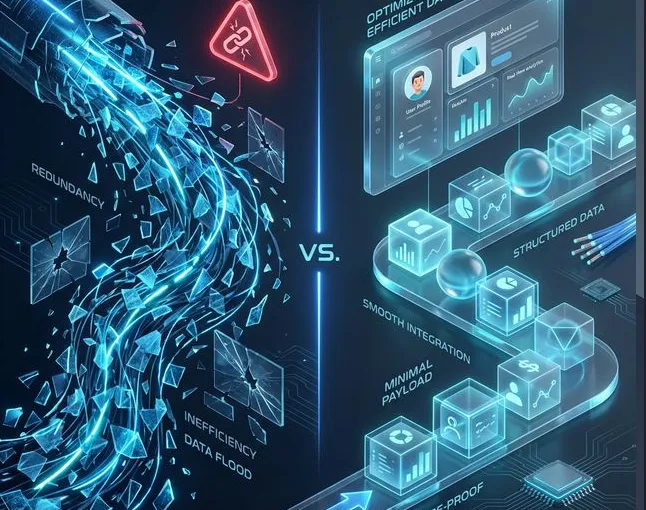
AI pisze kod szybko - ale czy Twoje API zwraca tylko to, co potrzebne?
AI pisze kod szybko. Czasem aż za szybko - i endpointy zaczynają zwracać więcej, niż frontend potrzebuje.
W defaultowym setupie modele lubią zwrócić cały obiekt lub całe kolekcje. Nie mówimy dokładnie czego i jak potrzebujemy - im więcej ogólników, tym większe pole do interpretacji.
Najczęściej AI:
- Nie robi DTO
- Nie filtruje danych
- Nie sprawdza, co faktycznie powinno iść na zewnątrz
To nie błąd - tak po prostu działają modele, które mają pełną dowolność w działaniu. Ogólny prompt = ogólny feature.
Problem: over-fetching generowany przez AI
W kilku projektach widziałem ten sam schemat:
// AI wygenerowało taki endpoint:[HttpGet("{id}")]public async Task<User> GetUser(int id){ return await _context.Users.FindAsync(id); // Zwraca CAŁY obiekt User ze wszystkimi polami: // Id, Name, Email, PasswordHash, CreatedAt, UpdatedAt, // InternalNotes, Role, LastLoginIp, FailedLoginAttempts...}Endpoint zwraca 10-20 pól, choć interfejs korzysta z 5. Endpoint zwraca całą kolekcję, a frontend potrzebuje tylko listy nazw i ich ilości.
Efekt? Bałagan, trudniejsze utrzymanie i dodatkowa praca przy każdym refaktorze.
Dlaczego to problem?
Każde dodatkowe pole to:
- Większa odpowiedź - więcej transferu, wolniejszy frontend
- Niepotrzebna ekspozycja szczegółów implementacji -
PasswordHash,InternalNotesczyLastLoginIpnie mają prawa opuścić serwera - Kruche API - zmiana wewnętrznego modelu łamie kontrakt z frontendem
- Trudniejsze testowanie - więcej pól = więcej edge case’ów
Nie chodzi o dramatyczne ryzyka bezpieczeństwa. Chodzi o higienę: API powinno zwracać tylko to, co jest potrzebne do działania UI.
Rozwiązanie: małe, celowe DTO
// DTO - tylko pola potrzebne frontendowipublic record UserProfileDto(int Id, string Name, string Email);
// Endpoint zwraca dokładnie to, czego UI potrzebuje[HttpGet("{id}")]public async Task<UserProfileDto> GetUser(int id){    return await _context.Users        .Where(u => u.Id == id)        .Select(u => new UserProfileDto(u.Id, u.Name, u.Email))        .FirstOrDefaultAsync();}
Dla list - analogicznie:
// Zamiast zwracać całą kolekcję obiektów:public record ProductListDto(int TotalCount, List<string> Names);
[HttpGet]public async Task<ProductListDto> GetProducts(int categoryId){    var query = _context.Products        .Where(p => p.CategoryId == categoryId);
    return new ProductListDto(        TotalCount: await query.CountAsync(),        Names: await query.Select(p => p.Name).ToListAsync()    );}
Reguła, którą dodaję do kontekstu AI
Poza code review przydaje mi się prosta reguła, którą wrzucam jako instrukcję dla agenta:
Przy pobieraniu i wyświetlaniu danych używaj minimalnej liczby pól.Między bazą a klientem stosuj małe DTO.Zawsze sprawdzaj, czy odpowiedź nie ujawnia więcej, niż potrzebuje UI.To naprawdę wystarczy. Wrzucam to do .github/copilot-instructions.md lub do pliku CLAUDE.md i agent zaczyna generować kod z DTO od początku, zamiast wymagać poprawek po fakcie.
Praktyczne zasady
- Jeden endpoint = jedno DTO - nie reużywaj tego samego DTO do różnych widoków, jeśli potrzebują różnych pól
- Nigdy nie zwracaj encji bazodanowej bezpośrednio z API - zawsze mapuj na DTO
- Nazywaj DTO po przeznaczeniu:
UserProfileDto,ProductListItemDto,OrderSummaryDto - Używaj
recordw C# - immutable, zwięzłe, idealne do DTO - Projekcja w LINQ (
.Select()) zamiast.ToList()+ mapowanie - to nie tylko czystsze, ale i szybsze (EF generuje SELECT tylko po potrzebne kolumny)
Efekt
API jest lżejsze, czystsze i łatwiejsze do rozwijania. Front jest szybszy i bezpieczniejszy. A Ty masz mniej pracy przy każdym kolejnym refaktorze.
Czy AI generuje zbyt „bogate“ odpowiedzi w Twoich projektach, czy masz już proces, który to trzyma w ryzach?
Nowe materiały prosto na maila
Publikuję nowy artykuł albo lekcję kursu — dostajesz jednego maila. Nic poza tym.
Bez cyklu wydawniczego i newsów o każdej premierze modelu
Zapisy do newslettera otwieram partiami, żeby nie zamieniać go w kolejny kanał ze spamem i recyklingiem linków.
Jeśli chcesz dostać informację przy następnym otwarciu zapisów, napisz na kontakt@efektywnydev.pl.
O autorze
Marcin Szymański
Od kilkunastu lat buduję systemy w .NET i Azure — obecnie rozproszony monitoring PingView. Piszę tu o pracy człowiek + agenci AI na realnych workflow, nie na demach. Zawodowo prowadzę audyty, rescue projektów i wdrożenia AI-assisted delivery w zespołach.